引子:一个反直觉的发现
说到“最慢的内存访问“,多数人第一反应是“随机访问“——没有局部性,cache 命不中,TLB 也失效。听起来很合理。
但如果我们告诉你,随机访问反而不是最慢的呢?
在一次精细的微基准测试中,研究者用 rdtsc 测量了访问一个 2^26 元素的 uint32 数组(65536 页 × 1024 元素/页)的总周期数,发现随机访问(Fisher-Yates 乱序)只消耗约 1.57B 周期。而当访问模式被精心设计成“跨页步进“时,这个数字直接飙到 2.06B 周期——比随机还慢 31%。
这不是 bug,这是内存层级(memory hierarchy)对你的一次精准反击。
让我们从基线开始,逐层拆解这场对抗实验。
基线:线性顺序访问
// 线性顺序遍历:看似"没什么优化"的基线
for (uint32_t i = 0; i < ELEMENT_COUNT; ++i) {
    total += data[i];  // data 是连续 uint32_t 数组
}
测试环境:Intel Core Ultra 7 268V,L1d 48KB(12-way,64 sets),编译选项 g++ -std=c++2a -O3,绑核 taskset -c 3。
结果:约 133M 周期。
这已经是非常优秀的数字了。线性遍历时,硬件预取器(hardware prefetcher)能准确识别出顺序访问流,提前将下一个 cache line(64 字节)拉入 L1d。平均每个元素访问成本接近一个 L1 cache hit(约 4 周期),实际测得约 2 周期/元素,说明 prefetcher 在大部分时间掩盖了真正的 cache miss 开销。
隐含的局部性红利:你的代码并没有做任何 cache优化——是硬件自动帮你拿了这份红利。
第一层对抗:跨 cache line 随机
如果把访问模式改成跨 cache line 步进(stride = 64 字节,即每访问一个 uint32_t,下一个要跳到 64 字节之外):
// 跨 cache line 步进:每 64 字节访问一个元素
// 假设 cache line 为 64 字节,则每次访问都落在不同的 line 上
for (uint32_t i = 0; i < ELEMENT_COUNT; ++i) {
    total += data[i * 64];  // 步进 64 字节,刚好跨过下一个 cache line
}结果:约 719M 周期。相比基线慢了 5.4 倍。
原因很直接:每个 cache line 64 字节,一个 uint32_t 4 字节,stride = 64 意味着每次访问都落在不同的 cache line 上。L1d 的空间局部性红利完全消失—— prefetcher 面对的是“跳跃式“流,无法预取到正确的行。
第二层对抗:跨页边界
现在让步进更进一步:跨过 4KB 页边界。
// 跨页步进:每 4096 字节(页大小)访问一个元素
// 硬件预取器不跨 4KB 页边界,因为虚拟地址到物理地址的映射在页边界处不确定
for (uint32_t i = 0; i < ELEMENT_COUNT; ++i) {
    total += data[i * 4096];  // 步进 4096 字节,跳到下一页
}结果:约 1.41B 周期。又比跨 cache line 慢了约一倍。
关键因素:硬件预取器不跨 4KB 页边界。虚拟地址到物理地址的翻译在页边界处是不确定的——预取器如果提前发起跨页预取,可能会读到错误的物理页。因此,所有主流处理器的预取器都默认把 4KB 页边界视为“不可逾越的红线“。一旦访问步进超过一页,prefetcher 直接放弃,每次访存都会触发真正的 L1d miss。
第三层对抗:组相联冲突
让我们做一道数学题:L1d 48KB,12-way,64 sets。每个 set 有 12 个 way(cache line),每个 line 64 字节。
如果步进恰好是 4096 字节(页大小),那么所有访问会映射到哪个 set?
// stride = 4096 时,以 page 为单位寻址
// 4096 / 64 = 64 个元素覆盖 64 个不同的 cache line
// 但这 64 个 line 全部映射到同一个 set(因为 set 索引只看地址的中间位)
// 12-way 意味着一个 set 最多容纳 12 个 line
// 实际可用容量:12 × 64 = 768 字节
for (uint32_t i = 0; i < ELEMENT_COUNT; ++i) {
    total += data[i * 4096];  // 所有访问映射到同一个 set,12-way 被压成 768 字节有效容量
}结果:约 2.06B 周期。相比线性访问慢了 15.5 倍。
这不是单纯的 cache miss——这是组相联冲突(set-associativity conflict)。L1d 的 12 个 way 只能容纳 12 个不同的 cache line。当访问流在同一个 set 内塞入超过 12 个不同的 line 时,必然发生 eviction。实际有效 L1d 容量从理论上的 48KB 塌陷成了 768 字节(12 × 64)。
这才是“最慢“访问模式的真正原因:不是没有局部性,而是局部性太好把所有访问挤进了同一个 set,让 12-way 的 L1d 退化成了“直接映射缓存“。
第四层对抗:TLB 抖动
在跨页步进的基础上,如果 stride 进一步缩小到 8 字节(一个 PTE 条目的大小):
// stride = 8 字节:每次访问跳到下一个 PTE 覆盖的地址
// 页大小 4KB,PTE 大小 8 字节,每页有 4096/8 = 512 个 PTE
// 访问 stride = 8 意味着每次都访问"下一行"PTE
// 效果:同时制造 L1d miss 和 TLB miss
for (uint32_t i = 0; i < ELEMENT_COUNT; ++i) {
    total += data[i * 8];  // stride = 8,PTE 步进
}结果:约 2.06B 周期(与 stride = 4096 相当)。边际收益极小。
8 字节 stride 的破坏力在于同时打击了两个维度:
- L1d 层面:8 字节步进仍然会让所有访问映射到同一个 cache set(因为 8 % 4096 的余数相对 64 字节 set index 粒度仍然塌陷到同一 set)
- TLB 层面:每个 PTE 8 字节,stride = 8 意味着每次访问都落在不同的 PTE 行内,L1 TLB miss 率极高
不过实测结果与 stride = 4096 几乎相同,说明当 L1d set 冲突已经足够严重时,TLB miss 的边际成本被掩盖了——主瓶颈仍然是 cache 层面的失效。
最终对抗:DRAM bank 通道冲突
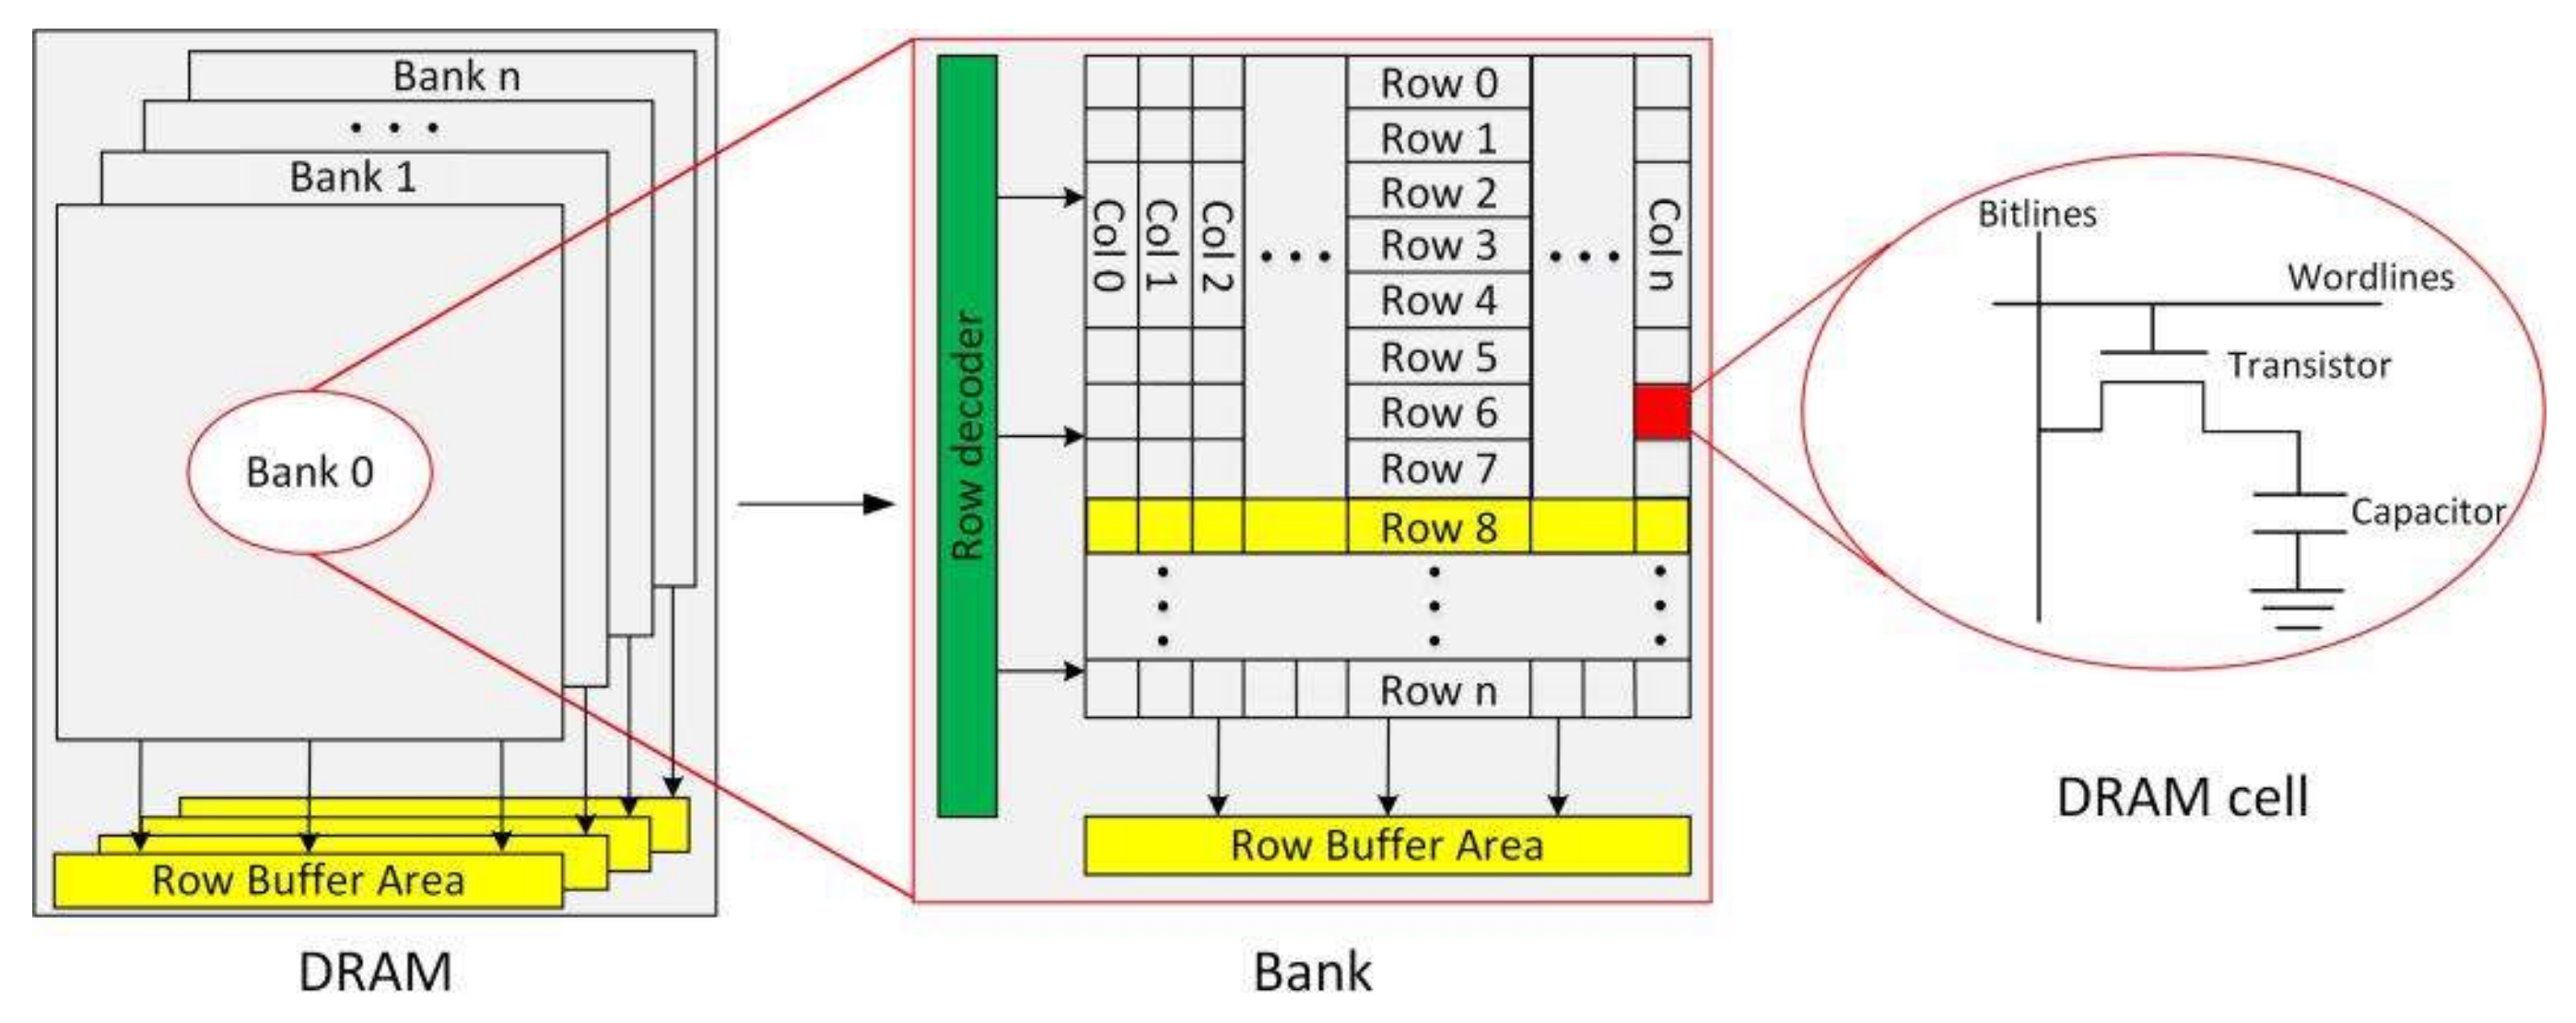
在 set 冲突的基础上引入 DRAM bank 冲突:
// 目标:让连续访问落在同一个 DRAM bank 上
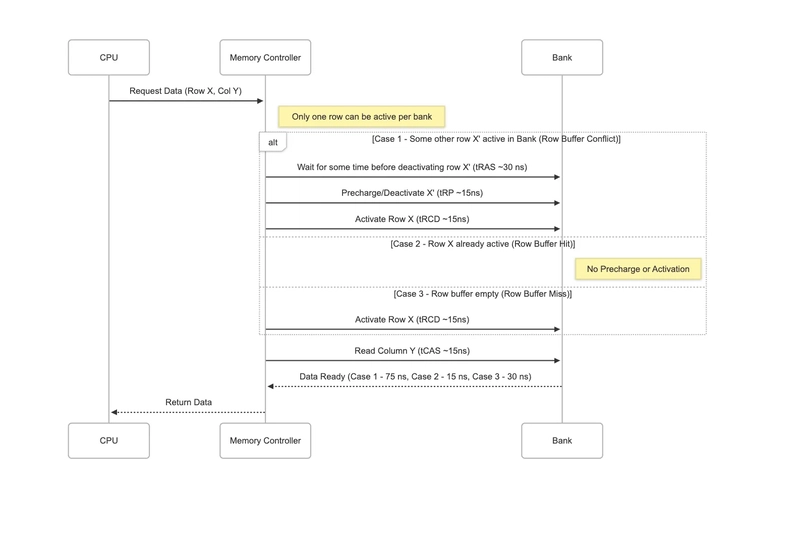
// DRAM bank 之间可以并行访问,同一 bank 的访问必须串行等待
// 配合 stride = 64(cache line 步进)让所有访问映射到同一 bank
for (uint32_t i = 0; i < ELEMENT_COUNT; ++i) {
    total += data[i * 64];  // stride = 64,同时制造 bank 冲突
}结果:约 2.08B 周期。相比 stride = 4096 的 2.06B,只慢了约 1%。
这说明:对于现代 CPU 来说,memory hierarchy 的上层(cache/TLB)才是主要瓶颈,DRAM bank 冲突带来的额外延迟在缓存完全失效的背景下边际收益极小。原文作者也承认,DRAM bank 冲突的效果与平台地址映射强相关,在不同 CPU 上可能无法稳定复现。
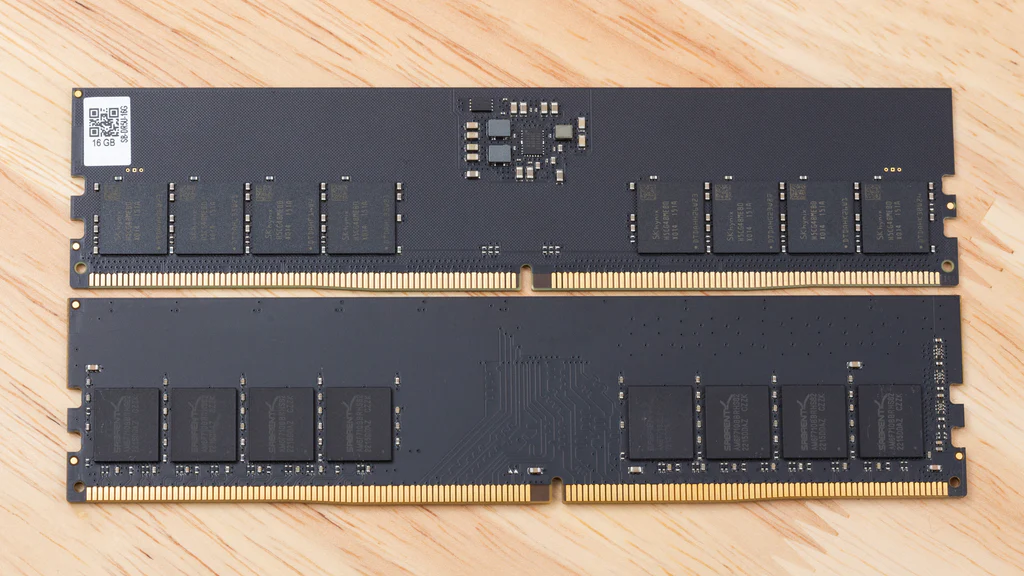
下图是原文中的三张关键参考图,帮助直观理解 DRAM 物理结构与访问时序:
结构化对比
| 访问模式 | 周期数 | L1d hit rate | TLB miss | 关键洞察 |
|---|---|---|---|---|
| 线性顺序(基线) | 133M | ~100%(prefetch 掩盖 miss) | 极低 | 硬件 prefetcher 是隐式优化器 |
| 跨 cache line 步进(stride=64) | 719M | 接近 0%(无局部性) | 低 | Prefetcher 不跨 cache line 预取 |
| 跨页步进(stride=4096) | 1.41B | 约 0%(跨页边界) | 高 | 预取器不跨 4KB 页边界 |
| stride=4096 + set 冲突(stride=64 同 set) | 2.06B | 约 0%(12-way 塌陷为 768B) | 高 | 组相联在冲突流下退化为直接映射 |
| DRAM bank 冲突 | 2.08B | 约 0% | 高 | 上层失效时,bank 冲突边际成本极小 |
[!NOTE] 以上周期数在 Intel Core Ultra 7 268V(Intel Core Ultra 7 268V)上测得,测试元素数量为 2^26(约 67M 元素),使用
rdtsc测量。不同 CPU 架构的 prefetcher 策略、cache 结构和 TLB 行为存在差异,数值仅供参考。
中国工程语境锚点
这些微架构层面的行为,在真实生产环境中有着直接的工程对应。
Kafka PageCache 抖动
Kafka 写入日志时,如果生产者发送的日志批次(batch)跨越多个 4KB 页,且消费端采用低延迟顺序消费,page cache 的换入换出(page-in/page-out)会形成一种“跨页步进“访问模式——每次消费都触发 page fault,数据不在内存必须从磁盘重新读取。当系统内存压力较大时,page cache 命中率骤降,消费延迟会出现类似“2.06B 周期 vs 133M 周期“的崩塌式增长。
应对:调整 log.segment.bytes(默认 1GB)使日志段对齐页边界,在高并发消费时确保 page cache 预热充足。
Redis 大 Key 删除
Redis 中一个 String 类型的 big key 可能占用数个连续的内存页。当使用 DEL 命令删除这个 key 时,Redis 需要释放它占用的所有页。如果 big key 跨多个 4KB 页,而删除操作的内部实现恰好以 4KB 为单位逐页遍历(类似 stride = 4096 的跨页步进),TLB 会在短时间内经历大量 PTE miss——对于 4GB 大小的 big key,TLB 抖动可能持续数十毫秒。
应对:使用 UNLINK 代替 DEL(异步释放),对超大 key 进行分桶存储,避免单次操作触发大规模 TLB 失效。
MySQL InnoDB buffer pool
InnoDB buffer pool 以 16KB 为默认页大小(4 个 OS 4KB 页)。当执行大范围顺序扫描(如 SELECT * FROM t WHERE id BETWEEN x AND y)时,如果扫描范围跨越多个非连续的 16KB 页,L1d 的 set 冲突与 TLB miss 会同时发生——这在 NUMA 架构下尤为明显:远程 NUMA 节点的内存访问延迟是本地的 2-3 倍,如果 buffer pool chunk 的物理分布恰好让访问流塌陷到同一 cache set,性能会进一步恶化。
应对:使用 innodb_buffer_pool_instances 将 buffer pool 分区,减少并发访问时的争用;对大表扫描配合 STRAIGHT_JOIN 强制驱动表顺序。
JVM GC pause 与内存局部性
JVM 的 G1GC 在处理 Humongous objects(超过 region 一半大小的对象,通常 > 512KB)时,会将这类对象分配在独立的 Humongous regions 中。如果应用代码频繁访问 humongous object 的不同页(stride 跨页),每次访问都会触发 L1d miss 和可能的 TLB miss,而 G1GC 的并发标记阶段(Concurrent Marking)本身就会导致 TLB flushed,进一步放大局部性失效。
应对:避免单对象过大(单个对象控制在 1MB 以内),对大对象使用堆外内存(off-heap)并自行管理局部性。
实战启示 Checklist
- 理解 cache line 粒度:批量顺序遍历数据时,确保数据在内存中是连续的,跨 cache line 的随机步进会让性能退化 5 倍以上。
- 警惕跨页步进:任何跨越 4KB 页边界的访问模式都会导致 hardware prefetcher 失效,prefetcher 不知道虚拟地址到物理地址的翻译,不跨页是合理的安全策略。
- 避免组相联冲突:如果你的访问流 stride 恰好是页大小(4096 字节),所有访问都会映射到同一个 cache set,12-way L1d 的有效容量会塌陷到 768 字节。在性能敏感路径上,避免 stride = page_size 的访问模式。
- TLB 抖动不一定是主瓶颈:当 cache miss 已经足够严重时,TLB miss 的边际成本会被掩盖。优先解决 cache 层问题。
- DRAM bank 冲突边际收益小:在上层缓存完全失效的情况下,DRAM bank 冲突带来的额外延迟相对有限。优化收益排序:L1d > L2 > L3 > DRAM。
- NUMA 场景关注物理分布:在 NUMA 系统上,数据在内存中的物理布局会影响 cache set 映射和远程访问延迟。对延迟敏感的核心数据,考虑使用
mbind/numactl绑核。 - 性能测量优先于猜测:memory hierarchy 行为复杂且平台相关,真实性能数据(
perf stat、rdtsc)比理论分析更可靠。
结语
CPU 从来不会真的“愤怒“——它只是诚实地执行你告诉它做的事。当你的数据访问模式恰好踩在 memory hierarchy 的每一个失效点上,L1d miss、TLB miss、set 冲突会像多米诺骨牌一样依次倒下,最终呈现出一个“比随机还慢“的反直觉结果。
理解 memory hierarchy 不是为了刻意跑出最慢的代码,而是为了理解为什么某些代码“莫名其妙地快“,以及如何在关键时刻——Kafka 消费者延迟飙高、Redis 大 key 删除卡顿、JVM GC pause 超出预期——找到那个被忽视的内存局部性问题。
下次当你抱怨“这个接口怎么这么慢“的时候,不妨先问一句:你的 CPU 是不是在无声地抗议?

